Sɔʼ pəpúŋ« Bienvenue » en ghomálá', langue bamiléké de l'Ouest-Cameroun
Fokam Emeric
Ingénieur et chercheur en IA, des modèles aux systèmes en production.
Je conçois des modèles d'IA, des pipelines de données et les backends qui les mettent en production, avec une recherche en NLP et en transport optimal sur les espaces d'embeddings, et des travaux sur les langues du Cameroun.
Ingénieur et chercheur en IA, je travaille sur tout le cycle de vie des systèmes d'IA, de la théorie à la production. Mon cœur de recherche est le traitement automatique des langues vu par le transport optimal : distances de Wasserstein, théorie de la perturbation spectrale et analyse des sous-espaces propres pour mesurer comment les espaces d'embeddings multilingues se déplacent d'un modèle ou d'une langue source à l'autre (recherche de Master, laboratoire UMMISCO, IRD / Université de Yaoundé 1).
IA appliquée
Côté appliqué, je conçois des systèmes LLM qui raisonnent et vérifient leurs réponses : notre pipeline text-to-SPARQL few-shot a remporté la piste espagnole « with mentions » du challenge WikiKGQA à ISWC 2026 et est publié dans CEUR-WS. Je mets aussi en production des modèles pour les langues et les accents du Cameroun (traduction vers le ghomálá', reconnaissance vocale du français camerounais).
Backend et intégration
Et je construis les backends distribués qui les portent : j'ai maintenu et fait évoluer une plateforme temps réel de plus de 30 microservices événementiels (RabbitMQ, Redis, Traefik) alimentée par des fournisseurs de cotes sportives, intégré des paiements Mobile Money et des API tierces sur des produits SaaS en NestJS, et je livre le tout avec Docker et la CI/CD.
Thèmes de recherche
Transport optimal
Géométrie de Wasserstein
Perturbation spectrale
Embeddings multilingues
Apprentissage de représentations
NLP pour langues peu dotées
Reconnaissance vocale
QA sur graphes de connaissances
Raisonnement des LLM & usage d'outils
Microservices événementiels
Curieux de nature, et ouvert aux questions de recherche voisines.
Stack technique
Outils et méthodes
Ce que j'utilise, regroupé par domaine, et ce que j'en fais.
Langages
Python
TypeScript
JavaScript
SQL
R
PHP
Machine learning
PyTorch
scikit-learn
TensorFlow
Hugging Face Transformers
NumPy
pandas
SciPy
Jupyter
LLM et IA agentique
LangChain
LangGraph
LlamaIndex
CrewAI
Model Context Protocol
Hugging Face
Tool calling
Prompt engineering
Recherche et bases vectorielles
RAG
FAISS
Chroma
pgvector
SPARQL
Data engineering
PostgreSQL
MariaDB
MySQL
Redis
RabbitMQ
Scrapy
Pentaho
ETL pipelines
Backend et intégration
NestJS
Node.js
Django REST Framework
Flask
Next.js
Symfony
Prisma
OpenAPI
JWT / OAuth 2.0
Analyse et visualisation
Power BI
R Shiny
Plotly
Matplotlib
React dashboards
Gradio
Infrastructure
Docker
Traefik
GitHub Actions
Linux
Let's Encrypt
Hugging Face Spaces
Domaines d'expertise
De la recherche à la production
Chaque réalisation est rattachée au domaine qu'elle illustre. Ouvrez une carte pour voir les captures et le détail technique.
01
Machine Learning Engineering
Un modèle n'a de valeur qu'une fois utilisé. Je l'emmène du notebook jusqu'au service en production.
Feature engineering, sélection et évaluation de modèles, deep learning avec PyTorch et TensorFlow, exposition des modèles derrière des API REST. Traduction neuronale, reconnaissance vocale et systèmes de recommandation mis en production.
PyTorch
◆Transformers
◆Seq2Seq
◆Wav2Vec 2.0
◆Recommender systems
◆Model serving
Université de Yaoundé 1 × UMMISCO
Ghomala' Translate
Traduction neuronale pour une langue peu dotée : du français vers le ghomálá', langue bamiléké tonale de l'Ouest-Cameroun, adossée à un dictionnaire sourcé et à une plateforme de contribution ouverte.
Projet CAFHOMEC · UMMISCO × Université de Yaoundé 1
KamerVox
Une reconnaissance vocale qui comprend les accents camerounais : modèles Wav2Vec 2.0 affinés sur des enregistrements de locuteurs de Yaoundé, en ligne sur Hugging Face.
Mon cœur de recherche est le NLP vu par le transport optimal : mesurer comment le sens se déplace entre espaces d'embeddings, modèles et langues.
Transport optimal pour le NLP : distances de Wasserstein entre distributions d'embeddings, théorie de la perturbation spectrale et analyse des sous-espaces propres pour quantifier comment les représentations multilingues se déplacent d'un modèle ou d'une langue source à l'autre. Volet appliqué : analyse sémantique par LLM et question-réponse sur le graphe de connaissances Wikidata.
Optimal transport
◆Wasserstein distance
◆NLP
◆Embedding geometry
◆Spectral perturbation
◆Multilingual representations
◆KGQA
Recherche principale · Mémoire de Master, laboratoire UMMISCO
WASER: optimal transport between embedding spaces
Mon axe de recherche principal : de combien le sens d'un corpus se déplace-t-il quand il est encodé par différents modèles multilingues ou via différentes langues sources ? Le transport optimal et la perturbation spectrale apportent une réponse fondée.
Les benchmarks gardent l'exigence intacte : compétitions régulières de data science et d'IA sur Codabench, Kaggle et Zindi, et membre actif de la communauté KmerAI.
KaggleZindiCodabenchNLP
03
Agents IA et systèmes LLM
Je conçois des systèmes LLM qui raisonnent, appellent des outils et vérifient leurs réponses au lieu de deviner.
Orchestration d'agents avec LangChain, LangGraph et CrewAI, appel d'outils et serveurs Model Context Protocol, génération augmentée par la recherche avec LlamaIndex et bases vectorielles (FAISS, Chroma, pgvector), échantillonnage multi-candidats avec sélection guidée par l'exécution, inférence de modèles open-weight.
LangChain
◆LangGraph
◆LlamaIndex
◆CrewAI
◆MCP
◆RAG
◆Tool calling
ISWC 2026
Agentic pipeline for WikiKGQA
Boucle génération–exécution–sélection : le LLM écrit des requêtes candidates, les exécute comme outil sur l'endpoint Wikidata et retient celle qui renvoie une réponse valide.
Série de projets d'applications LLM : chaînes, agents à outils, graphes d'états et pipelines RAG.
LangChainLangGraphRAGVector stores
04
Data Engineering et Data Analysis
Tout part d'une donnée fiable. Je la collecte, la nettoie, la fais circuler et la transforme en décisions.
Pipelines ETL, web scraping à grande échelle, modélisation relationnelle, ingestion et capture de données d'exécution, flux de données par messages et couches de cache. Analyse exploratoire et statistique, SQL analytique, tableaux de bord interactifs (Power BI, R Shiny, React) et reporting d'aide à la décision.
Web scraping
◆Scrapy
◆ETL
◆PostgreSQL
◆Orchestration
◆Dashboards
◆SQL
Laboratoire UMMISCO
Automated biblical text collection
Système de scraping automatisé pour constituer des corpus de textes bibliques destinés aux travaux de traitement des langues du laboratoire.
Scrapers des principaux sites d'emploi camerounais alimentant un agrégateur qui classe les offres selon le CV.
PythonScrapyDjangoPostgreSQL
Africa Systems
Vehicle traceability & monitoring
Traçabilité de bout en bout des données de véhicules : scripts de capture Python, jobs ETL orchestrés par Pentaho et tableau de bord de monitoring en direct.
PythonPentahoFlaskPostgreSQL
DataCamp · Data Scientist Professional
Data analysis projects
Des dizaines de projets sur données réelles, dont Products Sales Strategy, Android App Market, Predicting Credit Card Approvals et Nobel Prize Winners.
PythonpandasSQLR
05
Backend Engineering et intégration
Je construis et maintiens les backends distribués qui portent le trafic réel, les paiements et les intégrations tierces.
Microservices et architectures événementielles (RabbitMQ), cache distribué (Redis), authentification et autorisation (JWT, OAuth 2.0), passerelles de paiement et intégration d'API tierces, documentation OpenAPI.
NestJS
◆Node.js
◆Microservices
◆RabbitMQ
◆Redis
◆Payments
◆Docker
◆Traefik
Core Extreme
ReserveIT
WhatsApp devient un guichet de réservation ouvert 24 h/24 : un assistant IA gère la conversation, le créneau, le paiement Mobile Money et les rappels.
Maintenance et évolution d'une plateforme transactionnelle de plus de 30 microservices, alimentée en temps réel par des fournisseurs de cotes et de marchés (FeedConstruct, API-Sports).
Node.jsNext.jsRabbitMQRedis
Publications
Publications et travaux de recherche
Ma recherche principale sur le transport optimal pour le NLP, et un article évalué par les pairs sur la question-réponse sur graphes de connaissances.
Recherche principale · Mémoire de Master, laboratoire UMMISCO2025
Dans quelle mesure une représentation change-t-elle quand un même corpus est encodé avec différents modèles multilingues ou langues sources ? Ce travail modélise les transformations géométriques des espaces d'embeddings par la théorie de la perturbation spectrale, et mesure les distances entre distributions de représentations par transport optimal de Wasserstein et analyse des sous-espaces propres.
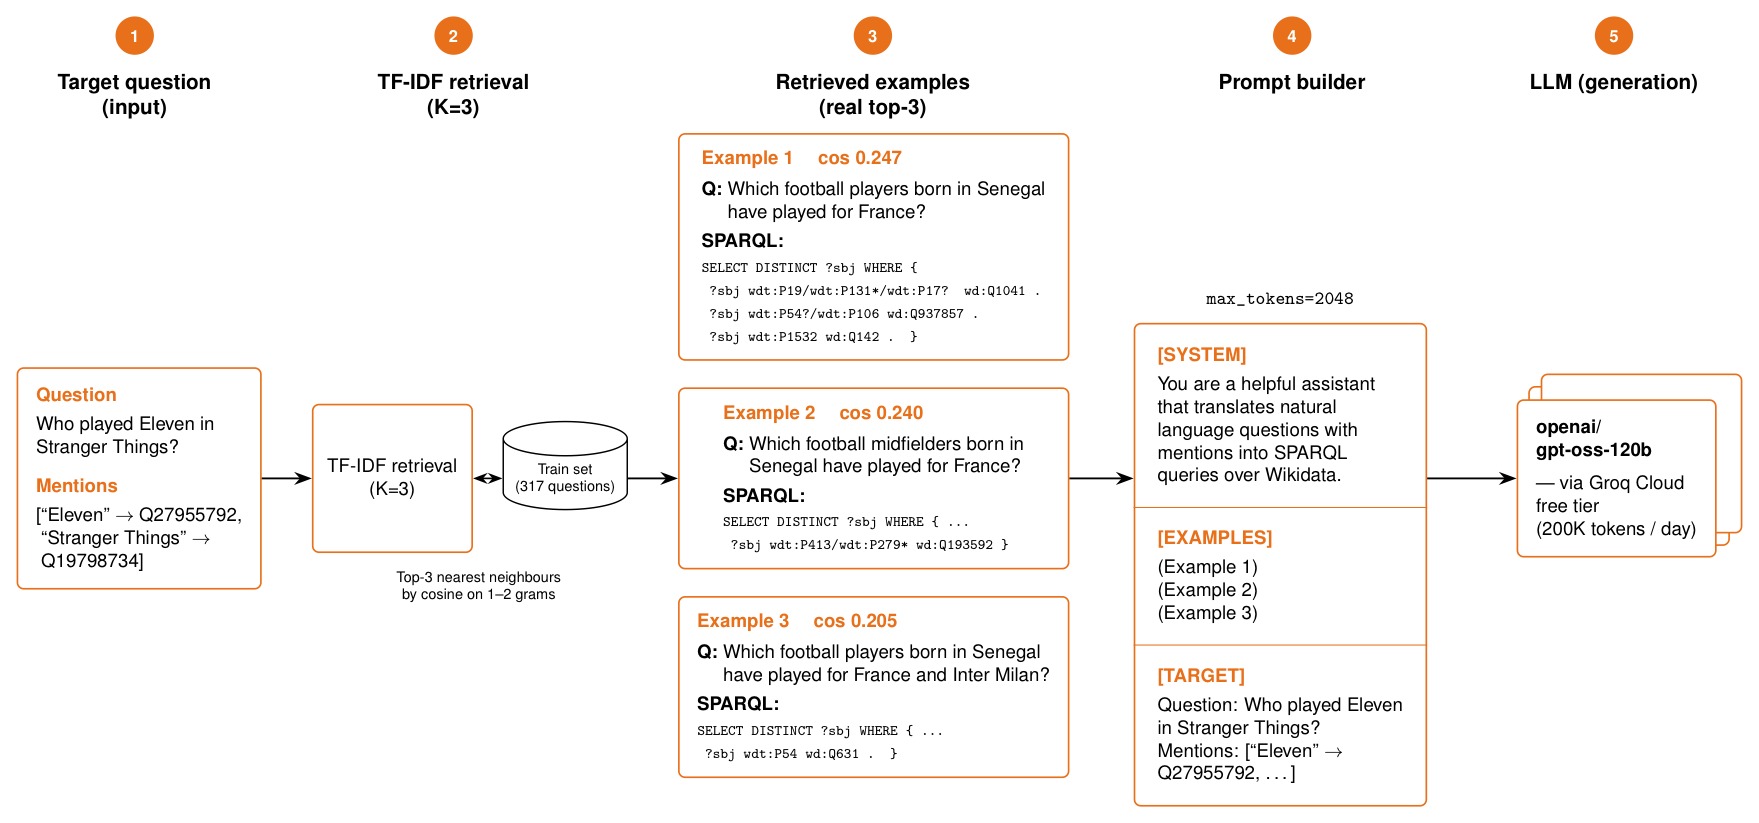
Nous présentons notre participation aux deux pistes « with mentions » (anglais et espagnol) du challenge WikiKGQA @ ISWC 2026, dont la tâche est de traduire une question en langage naturel en requête SPARQL exécutable sur un sous-graphe de Wikidata. Notre système enchaîne quatre étapes : un récupérateur TF-IDF qui sélectionne trois exemples d'entraînement proches, un prompt few-shot envoyé à un LLM open-weight, la génération de cinq candidats à températures mixtes (un déterministe, quatre à 0,7), puis la sélection du premier candidat qui renvoie un résultat non vide sur l'endpoint du challenge. L'analyse d'erreurs isole deux catégories résistantes : les questions à filtre de type, qui reposent sur la chaîne P31/P279* incomplète sur l'endpoint, et les requêtes COUNT, pour lesquelles le LLM oublie souvent l'agrégat. Le pipeline n'utilise que des modèles open-weight (gpt-oss-120b, llama-3.3-70b) servis gratuitement via Groq Cloud.
Figure : traitement d'une question, de la récupération TF-IDF à la génération par le LLM
Knowledge Graph Question AnsweringWikidataLarge Language ModelsSPARQL
Mon rôle : Présentation d'article · lauréat d'une piste du challenge WikiKGQA
ISWC est la principale conférence internationale de recherche sur le Web sémantique, les graphes de connaissances et les données liées. L'édition 2026 accueille le premier challenge WikiKGQA, qui évalue des systèmes de question-réponse sur Wikidata en anglais et en espagnol. J'y présente notre système text-to-SPARQL, lauréat de la piste espagnole « with mentions ».
Benchmark : 492 paires question–SPARQL bilingues anglais/espagnol construites sur QAWiki
Instantané figé de Wikidata servi par un endpoint QLever dédié
Quatre pistes évaluées en F1 macro QALD sur Codabench
Digital Avenues for Low-Resource Languages of Sub-Saharan Africa
DASSA'25
27–28 mai 2025 Yaoundé, Cameroun (hybride)
Mon rôle : Comité d'organisation, logistique
Workshop international de l'African Society in Digital Sciences (ASDS), porté par l'initiative AI4AfricanLanguages avec le soutien de l'Agence nationale de la recherche. Il réunit des chercheurs qui conçoivent des outils numériques pour les langues africaines peu dotées. J'ai fait partie de l'équipe d'organisation, en charge de la logistique.
Thèmes : collecte et curation de données, reconnaissance et synthèse vocale, ML explicable, multimodalité texte–audio, biais d'annotation
Six articles acceptés, de la reconnaissance des tons à la reconnaissance des émotions dans la parole
Organisé dans la salle de conférence du CNS-RIC-DSU du MINESUP, à Melen (Yaoundé)
Deux fils qui se nourrissent : construire des systèmes en entreprise, et faire de la recherche à l'université.
Expériences professionnelles
Aug – Oct 2023
Développeur web (PHP / Symfony)
Freelance · Télétravail (France)
Un premier projet client : base de données MariaDB, interface SASS et Bootstrap, déploiement sur Platform.sh.
Modélisation de la base de données relationnelle (SQL / MariaDB) à partir des règles métier du client.
Réalisation de l'interface en HTML, CSS, SASS et Bootstrap, responsive sur mobile et ordinateur.
Développement des fonctionnalités Symfony propres au projet et déploiement sur Platform.sh.
PHPSymfonyMariaDBSASSBootstrapPlatform.sh
Feb – Jun 2024
Stage Data Scientist & développeur backend
HS4HEALTH · Yaoundé
Mon premier modèle en production : un système de recommandation pour gHealth Village Connect, du nettoyage des données aux API REST.
Nettoyage et préparation des données de la plateforme pour constituer le jeu d'entraînement.
Conception du modèle de recommandation et évaluation avant mise en service.
Exposition du modèle via des API RESTful avec Django REST Framework.
Déploiement en production dans gHealth Village Connect (connect.ghealthvillage.com).
Pythonscikit-learnDjango RESTPostgreSQLRecommender systems
Sep 2024 – Jan 2025
Data Engineer / Data Analyst
Africa Systems · Douala
La donnée à l'échelle : capture et traçabilité des données de véhicules, jobs de collecte orchestrés avec Pentaho, API Flask et tableau de bord de monitoring.
Écriture de scripts Python de capture qui collectent et tracent les données d'exécution des véhicules.
Orchestration et planification des jobs de collecte et d'ETL avec Pentaho Data Integration.
Conception d'API Flask et gestion des bases PostgreSQL associées.
Réalisation d'un tableau de bord de monitoring en React pour suivre les flux de données et l'activité des véhicules.
PythonPentahoFlaskPostgreSQLReactETL
Sep – Dec 2025
Développeur backend (NestJS)
Core Extreme · Télétravail
Microservices et paiements : authentification sécurisée (JWT, OAuth), PostgreSQL, passerelles de paiement, sur des produits comme ReserveIT et une application de réservation de transats.
Conception et développement d'API pour plusieurs services dans une architecture microservices NestJS.
Mise en place de l'authentification et de l'autorisation sécurisées avec JWT et OAuth.
Intégration des moyens de paiement (dont Mobile Money) pour ReserveIT, l'assistant de réservation WhatsApp (reserveit.cm), et pour une application de réservation de transats.
Livraison de plusieurs fonctionnalités produit et conception des schémas PostgreSQL associés.
Documentation de toutes les API avec Swagger / OpenAPI.
Architecture événementielle à l'échelle : maintenance et évolution d'une plateforme transactionnelle de plus de 30 microservices alimentée par des fournisseurs de cotes en temps réel.
Maintenance et évolution d'une plateforme de plus de 30 microservices : débogage, nouvelles fonctionnalités et mises en production sans casser le flux d'événements.
Intégration des fournisseurs de cotes et de marchés (FeedConstruct, API-Sports) via un service dédié de consommation d'API tierces.
Communication asynchrone inter-services avec RabbitMQ et Redis comme cache distribué.
Conteneurisation des services avec Docker / Docker Compose et configuration de Traefik pour le routage et la sécurité.
Rédaction de tests unitaires et de la documentation des API.
Mathématiques et sciences physiques : les fondations de tout ce qui suit.
2020 – 2025
Master en informatique, option Data Science
University of Yaoundé 1 · Yaoundé
Cinq années d'informatique, de statistiques et de machine learning, complétées par le parcours DataCamp Data Scientist Professional et quatre certifications.
2025
Recherche de mémoire de Master
UMMISCO · Yaoundé
L'entrée dans la recherche : transport optimal et perturbation spectrale pour comparer des espaces d'embeddings. En mai, membre de l'équipe d'organisation du workshop DASSA'25 sur les langues africaines peu dotées.
Optimal transportNLPEmbeddings
Certifications
DataCamp · Data Scientist Professional
DataCamp · Data Analyst Professional
DataCamp · Data Scientist Associate
DataCamp · Data Analyst Associate
DataCamp · SQL Associate
Langues
FrançaisLangue maternelle
AnglaisProfessionnel
Contact
Discutons de votre projet
Un besoin, une question ou une collaboration : écrivez-moi, je réponds sous 24 h.
 Python
 TypeScript
 JavaScript
 SQL
 R
 PHP
 PyTorch
 scikit-learn
 TensorFlow
 Hugging Face Transformers
 NumPy
 pandas
 SciPy
 Jupyter
 LangChain
 LangGraph
 LlamaIndex
 CrewAI
 Model Context Protocol
 MariaDB
 MySQL
 Redis
 RabbitMQ
 Scrapy
 NestJS
 Node.js
 Django REST Framework
 Flask
 Next.js
 Symfony
 Prisma
 OpenAPI
 JWT / OAuth 2.0
 Plotly
 React dashboards
 Gradio
 Docker
 Traefik
 GitHub Actions
 Linux
 Let's Encrypt